
Винрейт, измеренный методом Монте-Карло на тысяче партий, известен с точностью ±3,1 процентного пункта, и правка, сдвинувшая его на два пункта, при такой выборке неотличима от шума. Точность растёт как корень из объёма: сузить интервал вдвое стоит вчетверо больше партий. Чтобы уверенно отличить 51% от 50%, нужно около 39’000 партий на конфигурацию, и разговор о балансе начинается не с числа побед, а с размера выборки.

Рис. 1. Доверительный интервал сужается как корень из числа прогонов
Пасьянс, с которого начался метод
Идея пришла Станиславу Уламу в 1946 году, когда он выздоравливал после болезни и прикидывал шансы выиграть в пасьянс «Кэнфилд». Точный расчёт комбинаторики оказался неподъёмным, а многократная случайная раскладка давала оценку сразу. Джон фон Нейман подхватил замысел, Николас Метрополис дал методу имя в честь казино, куда любил ездить дядя Улама, а первая публикация вышла в Journal of the American Statistical Association в 1949 году.
Метод Монте-Карло – оценка величины по множеству случайных испытаний. Придуманный ради карточной игры, он вернулся в геймдизайн через семьдесят лет уже как инструмент балансировки. Вопрос при этом остался ровно тот же: сколько раз надо разложить пасьянс, чтобы поверить полученному результату?
Ответ даёт стандартная ошибка доли. Для винрейта p, измеренного на n партиях, она равна корню из p(1 − p)/n, а полуширина 95-процентного доверительного интервала – 1,96 такой ошибки. Знаменатель под корнем и есть главная новость: точность растёт не пропорционально усилиям, а намного медленнее числа прогонов.
Первая оговорка касается границ формулы. Простая оценка «доля плюс-минус ошибка» известна как интервал Вальда и плохо работает при винрейтах у края диапазона и малых выборках. Эдвин Уилсон предложил в 1927 году интервал, основанный на обращении score-критерия, а Браун, Цай и Дасгупта в обзоре 2001 года прямо не рекомендуют интервал Вальда. Для винрейтов около половины разница невелика, для редких событий вроде «шанс собрать комбинацию» она становится принципиальной.
Вторая оговорка касается смысла. Статистическая различимость и важность для игрока – разные вещи. Достаточно большая выборка отделит от нуля любое отличие, включая то, которого никто никогда не заметит.
Винрейт: цена одного знака после запятой
Счёт интервала прямой и помещается в одну строку. При винрейте около половины доверительный интервал составляет ±9,8 процентного пункта на ста партиях, ±3,1 на тысяче, ±0,98 на десяти тысячах, ±0,31 на ста тысячах и ±0,10 на миллионе.
Отсюда практическое правило. Первый знак после запятой в винрейте стоит примерно десять тысяч партий, второй – миллион. Дизайнер, объявивший «винрейт 51,3%» по итогам пятисот прогонов, называет три цифры, из которых достоверна одна.
Сравнение двух конфигураций дороже измерения одной. Чтобы при уровне значимости пять процентов и мощности восемьдесят процентов отличить 55% от 50%, хватит 1’565 партий на конфигурацию; для 53% нужно 4’355, для 52% – 9’806, а для 51% – уже 39’240.
Порог в 39’240 партий ломает привычную практику. Типичная правка баланса двигает винрейт на один пункт, а обычный прогон – несколько сотен партий, то есть в сто раз меньше необходимого. Решение принимается по шуму, и следующая правка откатывает предыдущую.
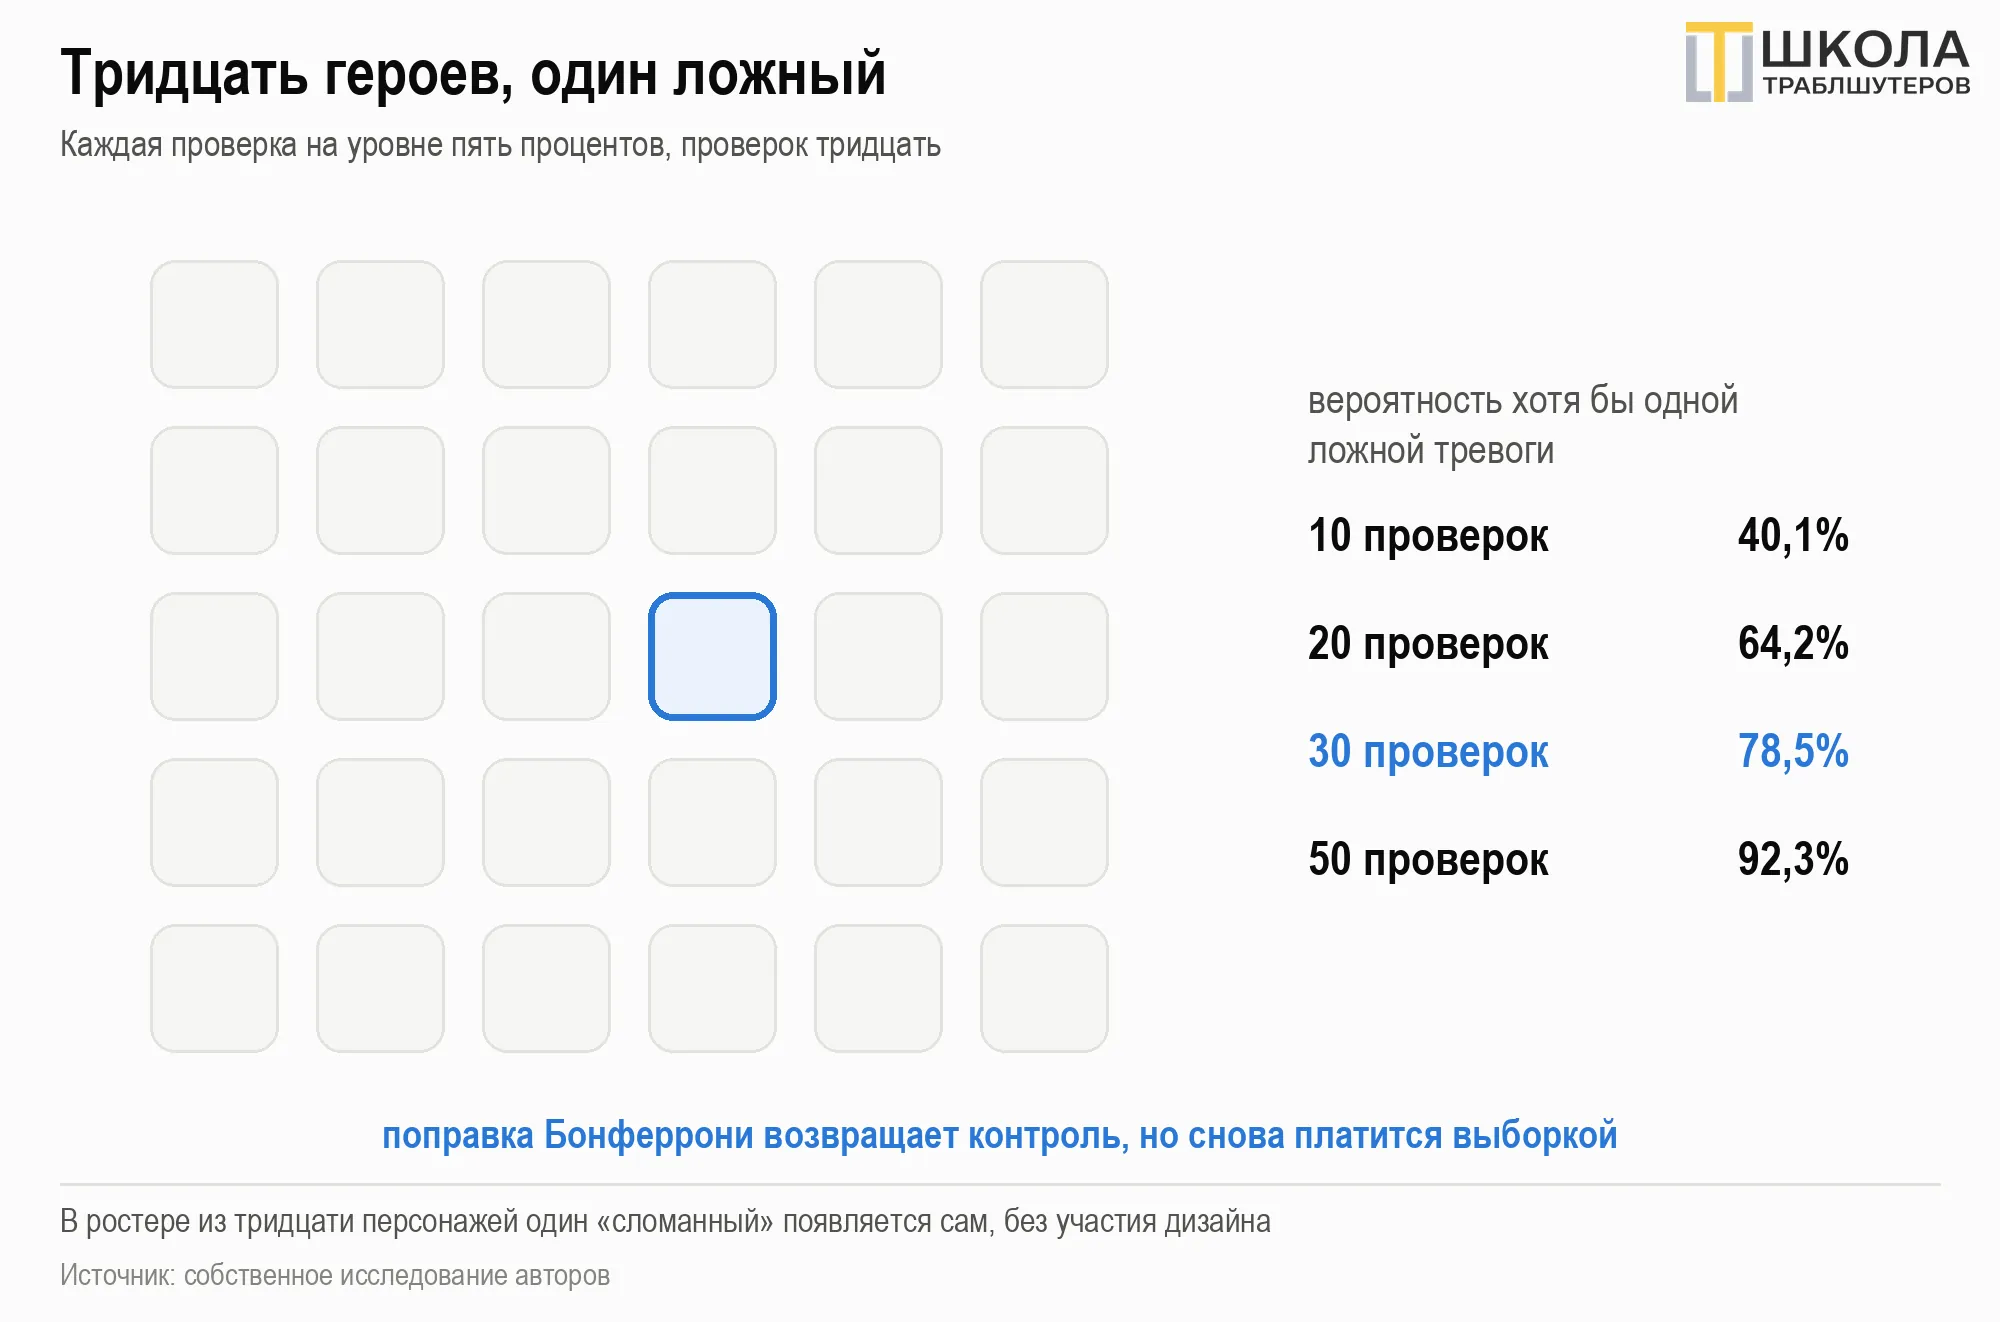
Рис. 2. Тридцать проверок на уровне пять процентов: ложная тревога почти неизбежна
Тридцать героев: ошибка приходит сама
Баланс никогда не меряют на одном герое. Проверяют набор фракций, список карт, колоду, ростер – сущности, связанные игровыми механиками. На множестве сравнений накапливается ошибка, о которой в отчётах обычно не пишут.
Если каждую проверку вести при уровне значимости пять процентов, вероятность получить хотя бы одно ложное срабатывание равна единице минус 0,95 в степени числа проверок. Для десяти героев выходит 40,1%, для двадцати – 64,2%, для тридцати – 78,5%, для пятидесяти – 92,3%.
В ростере из тридцати персонажей почти наверняка найдётся один «сломанный», которого сломала арифметика, а не дизайн. Поправка Бонферрони делит уровень значимости на число проверок и возвращает контроль, но платить за контроль снова приходится объёмом выборки.
Парные прогоны: та же точность заметно дешевле
Общие случайные числа – приём, который стоит знать до покупки вычислительных мощностей. Две конфигурации прогоняются не независимо, а на одних и тех же сидах: одна карта, одна раздача, одни точки появления. Тогда разница исходов объясняется правкой, а не тем, что одной стороне просто больше повезло.
Выигрыш считается через корреляцию парных исходов и зависит от того, какую долю дисперсии общий сид фиксирует. Симуляция на шестистах тысячах пар даёт: при двадцати процентах общей дисперсии корреляция составляет 0,13 и выигрыш лишь в 1,1 раза, при сорока – 0,26 и 1,4 раза, при шестидесяти – 0,41 и 1,7 раза, при восьмидесяти – 0,59 и 2,4 раза.
Порог выборки пересчитывается тем же множителем. Прежние 39’240 партий на различение 51% и 50% превращаются в 16’106 при восьмидесяти процентах общей дисперсии. Парный прогон тем выгоднее, чем позже траектории расходятся после правки, и почти бесполезен там, где одно изменение сразу уводит партию в другую сторону.

Рис. 3. Парные прогоны снижают стоимость различения в 2,4 раза
Агенты: чем именно измеряют
Зук, Харрисон и Ридл предложили проверять баланс агентами разной силы на основе поиска по дереву Монте-Карло: у сбалансированной игры равные по силе агенты дают равные винрейты, а разные по силе – не должны. Бо и Баккес на конференции IEEE CIG в 2016 году применили Монте-Карло к асимметричным играм, итеративно подстраивая атрибуты действий.
Слабый агент измеряет баланс для слабого игрока. Расхождение между тем, что показали симуляции, и тем, что почувствовали люди, – отдельная, систематическая ошибка, и числом прогонов её не уменьшить.
Рупп с соавторами проверил стык симуляций и восприятия на живых тестировщиках и показал: настройка эвристическими агентами в большинстве случаев улучшает и баланс, который воспринимают люди.
Что запомнить?
- Точность винрейта растёт как корень из объёма выборки: сузить интервал вдвое стоит вчетверо больше партий.
- Общие сиды сокращают выборку до 2,4 раза, пока правка не расщепляет партию.
- Тридцать проверок на уровне 5% дают ложную тревогу с вероятностью 78,5%.
- Систематическую ошибку слабого агента числом прогонов не исправить.
- Отличить 51% от 50% стоит около 39’000 партий на конфигурацию.
Заключение
Исследования смещаются от вопроса «сколько прогонять» к вопросу «как распорядиться бюджетом прогонов». Рупп, Эберхардингер и Эккерт в IEEE Transactions on Games за 2024 год ставят задачу балансировки уровней как порождение контента обучением с подкреплением и отдельно исследуют, при каком числе симуляций колебания винрейта опускаются до приемлемых.
Параллельно вырос слой промышленных инструментов. Группа SEED в Electronic Arts с 2020 года публикует работы о тестировании глубоким обучением с подкреплением, а Unity вместе с Google вывела симуляции баланса в облачный сервис. Дешёвый прогон меняет экономику решения: если партия стоит доли цента, сорок тысяч партий перестают быть препятствием.
Практический порядок работы:
- назвать заранее величину сдвига, который считается значимым, и от неё рассчитать необходимый объём выборки
- прогонять две конфигурации на одних и тех же сидах, пока правка баланса не расщепляет партию с первого хода
- делить уровень значимости на число проверяемых героев, карт или фракций
- публиковать винрейт вместе с интервалом и числом партий, иначе цифры после запятой вводят в заблуждение
- сверять итог симуляций с живыми тестировщиками, потому что систематическую ошибку агента объёмом выборки не лечат.
Поставьте расчёт объёма первым шагом: выборка, подобранная после прогона, всегда оказывается достаточной. Число побед говорит, кто выиграл. Размер выборки говорит, стоит ли этому числу верить.