
Семь вопросов «да или нет» хватит, чтобы найти одну заявку среди сотни, а двадцать – среди миллиона. Каждый вопрос отбрасывает половину вариантов, если список упорядочен заранее. Основатель «Школы траблшутеров», экс-директор Альфа-Банка по процессам, Олег Брагинский показывает двоичный поиск и поиск предела нагрузки в трёх нотациях.
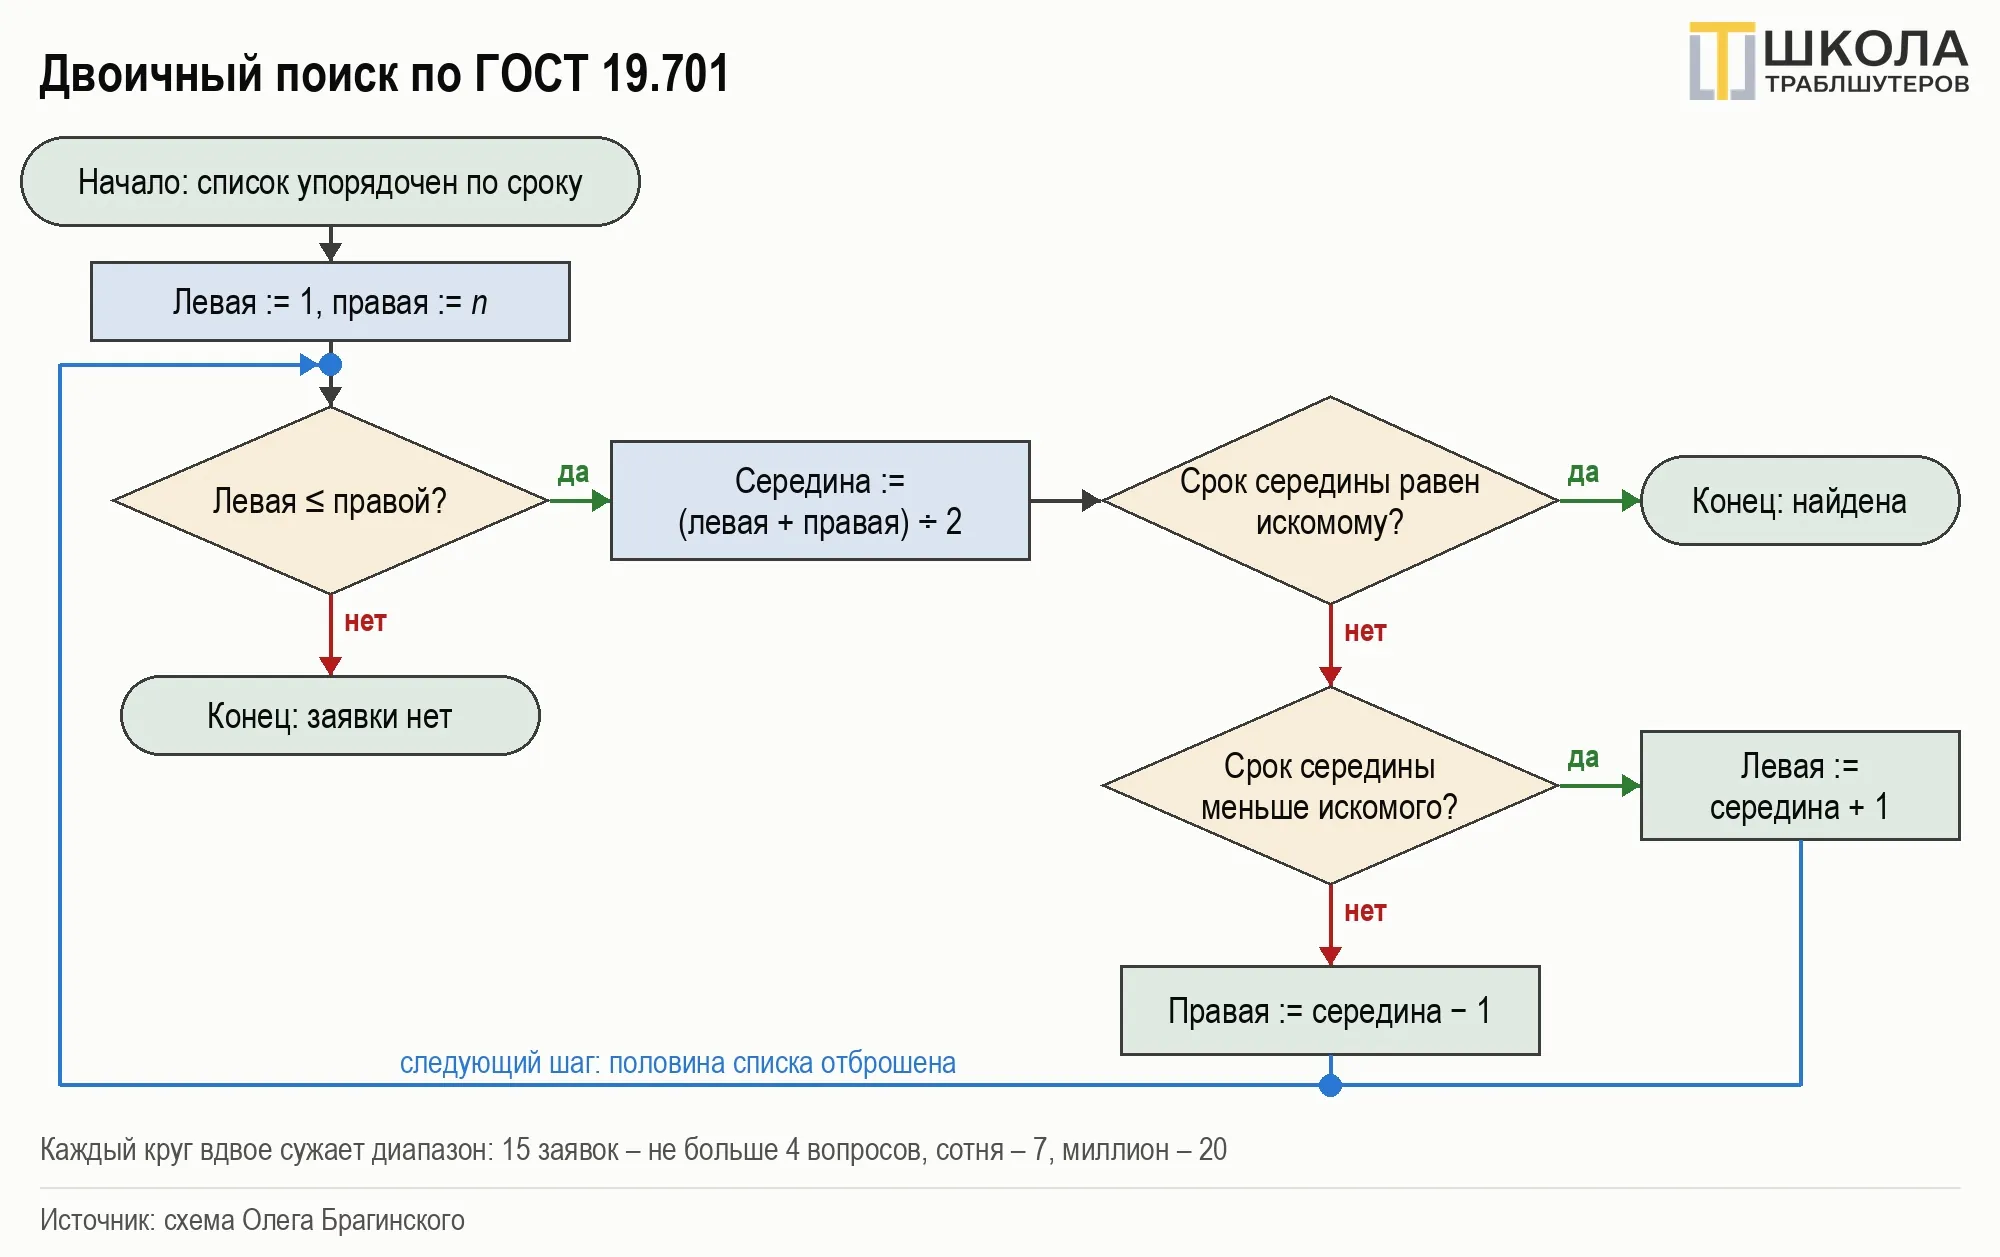
Рис. 1. Каждый круг сравнивает искомый срок с серединой и сужает список вдвое
Сложная итальянская пищевая линия начинала непредсказуемо сбоить при высокой нагрузке: стоило начаться сезону, инженеры настораживались. Через двое-трое суток непрерывной работы она ломалась. Подозревали нестабильное электричество, недостаточную промывку, разбавленную химию, пропуски в обслуживании, плохую подготовку сырья.
Причину нашли за семь шагов, каждый раз отсекая половину версий. Виновником оказалось ведро с тряпками: клинеры меняли в нём воду четыре раза в день, а нужно было каждые два часа. При большом потоке продукции копились жир, чешуя и волокна плавников. Рост объёма стали компенсировать более частой мойкой инвентаря и свежими растворами.
Короткий ответ: двоичный поиск – способ найти нужное, каждый раз деля круг кандидатов надвое. Сотне заявок хватит семи вопросов, миллиону – двадцати, но только если список упорядочен. Тот же приём находит предел нагрузки системы и причину сбоя. Рисовать его руководителю удобнее всего деревом решений.
Как устроен двоичный поиск?
Двоичный поиск – способ найти элемент в упорядоченном списке, сравнивая искомое с серединой оставшегося отрезка. Середина раньше искомого – левая половина больше не нужна, позже – правая. Отрезок сжимается вдвое, пока искомое не найдётся или отрезок не опустеет.
По ГОСТ 19.701 это один цикл с тремя ромбами: остался ли отрезок, совпала ли середина и в какую сторону двигаться. Две границы сходятся навстречу друг другу, а синяя стрелка возврата показывает, что каждый круг отбрасывает половину.
Как «Кедр» находит заявку за три вопроса?
В очереди сервисной компании «Кедр» пятнадцать заявок, упорядоченных по сроку: от одного до двадцати двух дней. Клиент звонит узнать, где заявка со сроком четырнадцать дней. Диспетчер не листает список сверху, а открывает середину.
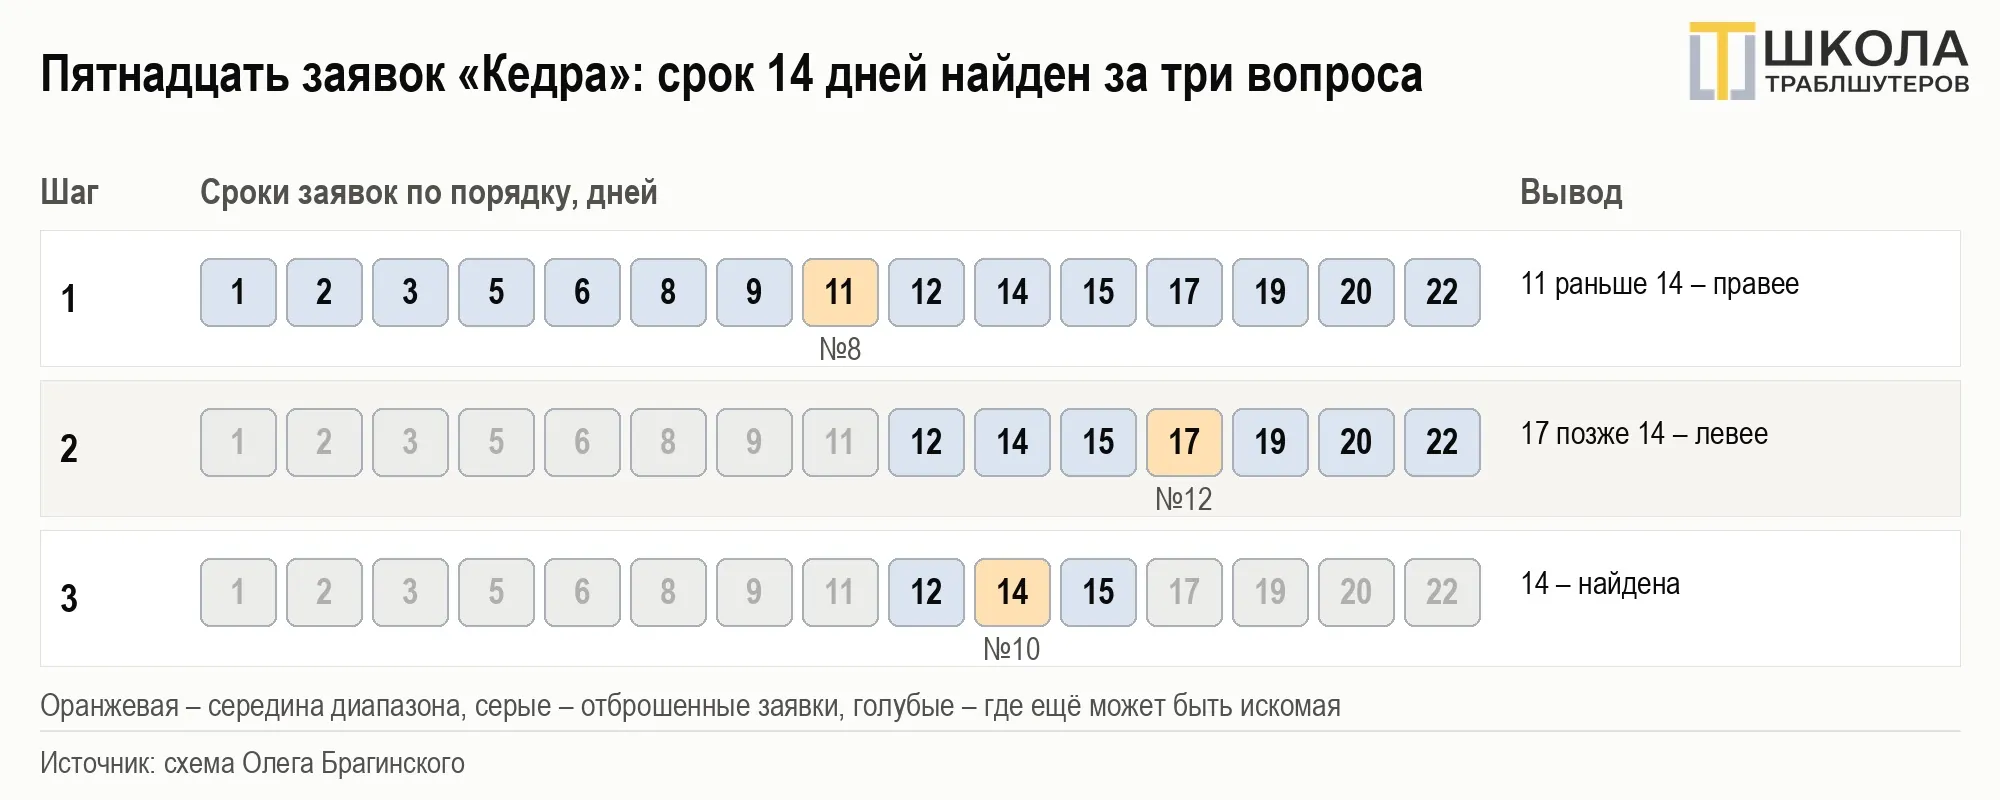
Рис. 2. Три шага поиска: середина, половина, ещё половина
Восьмая заявка – одиннадцать дней, раньше искомой, значит, левая половина отпадает. Середина правой – семнадцать дней, позже, отпадают ещё четыре. Третий вопрос попадает точно. Перебор сверху потребовал бы десяти сравнений, двоичный поиск обошёлся тремя.
Почему вопросы траблшутера – то же дерево?
Дерево решений – рисунок, где в каждом узле задан вопрос, а ветки ведут к ответам «раньше» и «позже» или «да» и «нет». Двоичный поиск по пятнадцати заявкам превращается в дерево из четырёх уровней: глубина дерева и есть наибольшее число вопросов.

Рис. 3. Путь к заявке со сроком 14 дней проходит через три узла дерева
Траблшутер сужает круг гипотез так же. «Проблема до шлюза или после?», «у всех клиентов или у части?», «в рабочие дни или в выходные?» – три вопроса оставляют восьмую часть подозрений. Важно, чтобы ответ делил гипотезы примерно поровну.
Сколько стоит поиск?
Перебор находит заявку в среднем за половину длины списка, двоичный поиск – за показатель степени двойки, накрывающей список. Сотня – 7 вопросов вместо 50 в среднем, тысяча – 10 вместо 500, миллион – 20 вместо полумиллиона, а база на 25 млн записей – 25 вопросов.
Идея проста, а реализация коварна. Первый двоичный поиск опубликовали в 1946 году, а версия, верная для списка любого размера, появилась только в 1962-м. В 2006 году Джошуа Блох из Google сообщил об ошибке в стандартной библиотеке Java, прожившей около девяти лет. Руководителю вывод один: писать поиск заново не нужно – он уже встроен в инструменты.
В Excel ВПР с интервальным просмотром и ПОИСКПОЗ с приблизительным совпадением ищут именно так. На неотсортированном столбце они молча вернут неверный ответ.
Где ловушка?
Двоичный поиск бессилен без сортировки. Базы страховой компании хранили сведения обо всех подержанных автомобилях местного рынка, а объявления лежали в хронологическом порядке. Поиск превращался в каторгу: каждое обращение перебирало всё подряд.
Пришлось изменить структуру базы – упорядочить записи по ключам поиска. Упорядочивают один раз, а экономят на любом запросе, и чем чаще ищут, тем быстрее это окупается.
Как найти предел нагрузки?
Поиск по ответу – способ найти неизвестную величину, когда можно проверить любое значение: «держит или нет». Сначала значение удваивают до первого отказа, затем отрезок между последним успехом и отказом делят пополам, как список заявок.
Допустимую нагрузку системы ввода кредитных заявок искали параллельно работающими ноутбуками: каждый имитировал до 32 человеческих сессий. Удвоение ноутбуков быстро находит масштаб, деление отрезка – точную границу.

Рис. 4. Пять прогонов с удвоением и пять с делением отрезка дают предел
На примере с шагом в восемь сессий удвоение доходит до отказа на 512, а деление сужает отрезок 256–512 до предела в 360 за пять шагов. Всего десять тестов вместо сорока пяти при повышении нагрузки по восемь сессий.
Когда двоичный поиск уместен?
Он уместен везде, где варианты можно упорядочить или где проверка отвечает «больше или меньше»: поиск в реестре, подбор порога скоринга, лимита, цены, нагрузки. Он же ищет, после какой версии сломалась система: разработчики делят историю изменений пополам.
Неуместен он там, где порядок навести нельзя или дорого, а искать нужно один раз: перебор тогда честнее. В следующей статье сборника – очередь с приоритетом: как ключевой клиент обходит общую очередь, не ломая её.
Какими нотациями рисовать поиск?
ГОСТ 19.701 точно передаёт цикл с границами, но три ромба подряд читаются тяжело, а смысл «половина отброшена» прячется в стрелке возврата. Его ценят авторы технических заданий и тестировщики: каждый ромб превращается в проверку.
Дерево решений показывает не алгоритм, а все возможные пути поиска сразу. Его любят аналитики и консультанты: глубина дерева сразу говорит, сколько вопросов понадобится в худшем случае, а путь к ответу виден глазами.
Структограмма Насси – Шнейдермана укладывает оба поиска в рамки без стрелок. Её предпочитают преподаватели и разработчики: развилка внутри развилки читается без усилий, а в поиске предела видны два цикла подряд – удвоение и деление.

Рис. 5. Поиск заявки и поиск предела нагрузки в рамках структограммы
Какая нотация лучше?
Лучшая нотация для двоичного поиска – дерево решений: 21 балл против 20 у структограммы и 15 у ГОСТ. Руководитель за минуту видит главное: каждый вопрос делит варианты пополам, а число уровней – цена поиска. Вес вопроса о руководителе удвоен: сборник написан для него.
Структограмма отстала на балл и выигрывает у дерева для разработчика: она описывает поиск в любом списке, а дерево – в конкретном. ГОСТ остаётся для технических заданий.

Рис. 6. Оценка трёх нотаций: 21, 20 и 15 баллов
Что сделать руководителю?
Хватит четырёх шагов:
- Проверьте, упорядочены ли реестры, в которых сотрудники ищут чаще всего.
- На разборе сбоя требуйте вопросы, которые отсекают половину гипотез.
- Предел нагрузки ищите удвоением и делением пополам, а не мелкими шагами.
- В таблицах пользуйтесь встроенным двоичным поиском, а не самодельным.
Что запомнить?
- двоичный поиск делит круг кандидатов пополам на каждом шаге
- сотне заявок хватает семи вопросов, миллиону – двадцати
- без упорядоченного списка метод даёт неверный ответ
- предел нагрузки находят удвоением и делением отрезка
- двоичный поиск лучше всего рисовать деревом решений.